Общий почтовый ящик со счетами, договорами, заявками, медицинскими формами и подтверждающими документами нельзя считать проблемой документов. Это операционное узкое место. Команды теряют время, открывая файлы, определяя тип документа, разыскивая недостающие страницы и направляя работу в нужную систему. Чтобы создать ИИ-классификаторы документов, которые приносят измеримую пользу, компании нужна не только модель, расставляющая метки на PDF. Нужен рабочий процесс уровня продакшена, который справляется с несовершенными входными данными, подключён к бизнес-системам и понимает, когда привлечь человека.
Разница существенная. Proof of concept может правильно распознавать несколько категорий документов на чистой выборке. Классификатор в продакшене обязан работать, когда сканы перекошены, поставщики меняют шаблоны, файлы приходят вложениями в письма, а результат с низкой уверенностью может задержать платёж, андеррайтинг, обработку страхового случая или проверку на соответствие требованиям.
Начинайте с решения, а не с документа
Первый вопрос звучит не как «Какую ИИ-модель нам использовать?». Он звучит так: «Какое решение станет быстрее или точнее, если тип документа известен?»
В кредиторской задолженности классификация может отделять счета, кредит-ноты, заказы на закупку и акты приёмки ещё до извлечения данных и проводки в ERP. В страховании она может разделять уведомления об убытке, полицейские протоколы, сметы, медицинские документы и переписку, чтобы каждый документ попадал в правильный процесс урегулирования. В кредитовании классификация отличает банковские выписки, налоговые декларации, справки о доходах, удостоверения личности и вспомогательные приложения до того, как пакет уйдёт на андеррайтинг.
Подход «сначала решение» защищает от типичной ошибки: широкой таксономии, которая выглядит интересно, но бесполезна для операций. Классификатор должен возвращать категории, за которыми следует понятный следующий шаг. Это может быть отправка файла в очередь, выбор схемы извлечения, запрос недостающего документа, применение политики хранения или создание кейса в CRM.
Определите цену каждой ошибки до начала разработки. Если маркетинговую брошюру примут за договор, вреда может не быть. Если налоговую форму примут за банковскую выписку, ошибки пойдут дальше по цепочке. Для одних классов нужны высокие пороги автоматизации, другие допускают более низкий порог с последующей проверкой. Правильная архитектура зависит от риска, объёма, вариативности документов и наличия проверяющих.
Архитектура ИИ-классификаторов документов
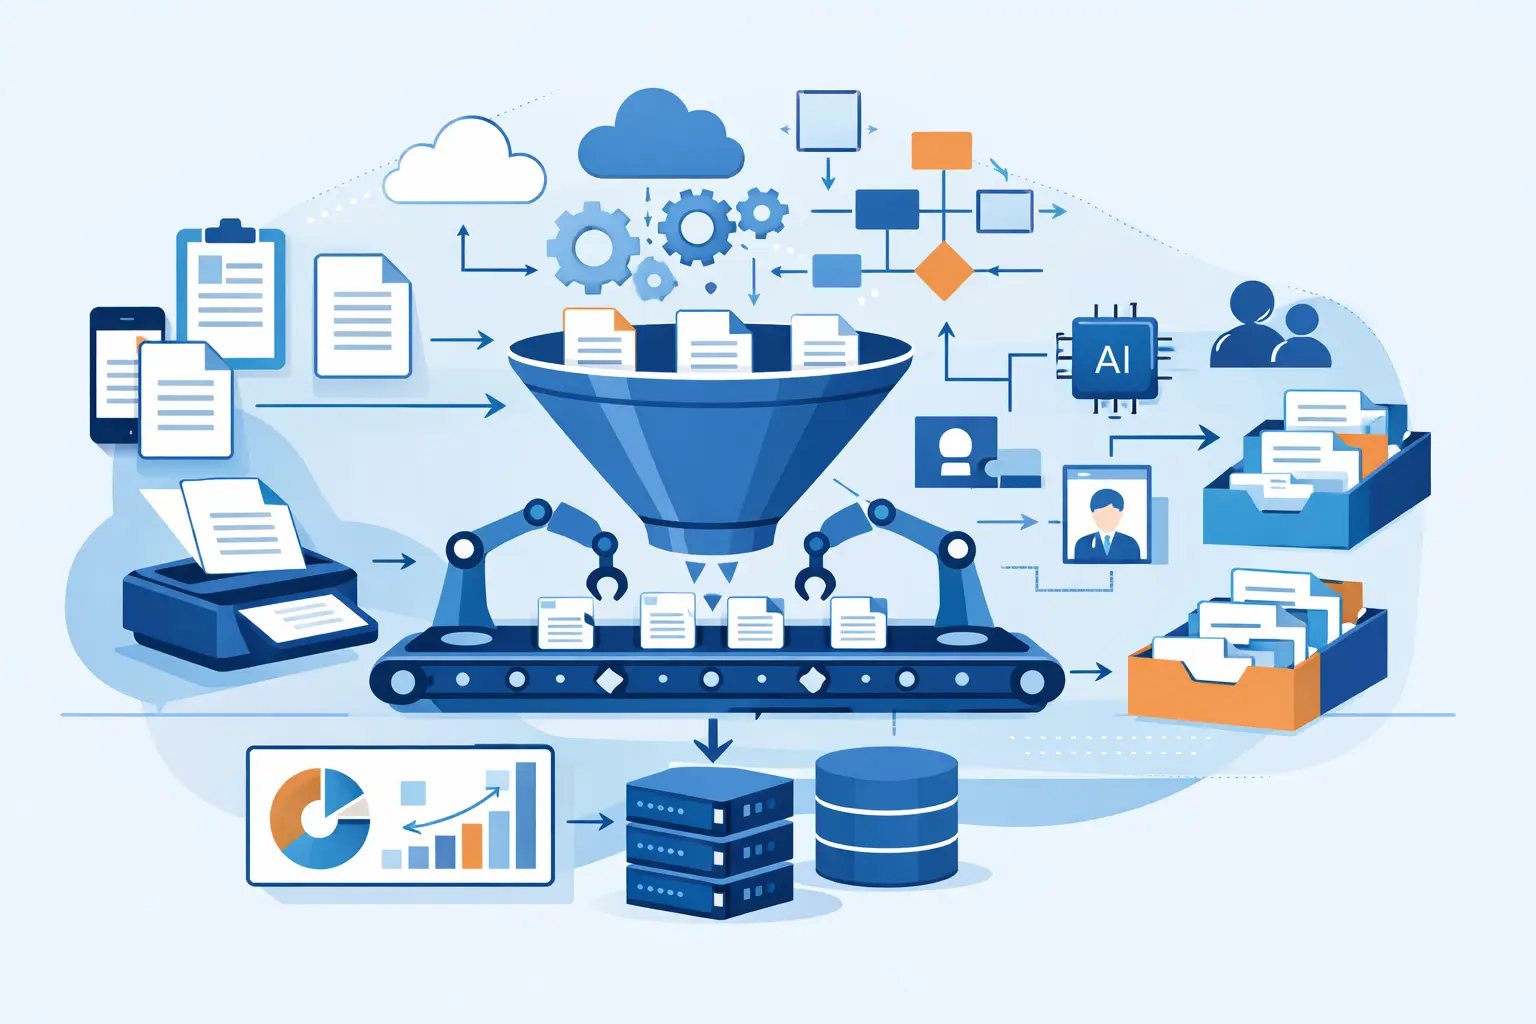
Надёжное решение представляет собой конвейер, а не один промпт или вызов модели. Конвейер начинается с приёма: файлы поступают через почту, защищённые порталы загрузки, сканеры, API, облачные хранилища или существующие прикладные бизнес-системы. До начала ИИ-обработки каждому файлу нужны уникальный идентификатор, запись об источнике, метка времени, контроль доступа и аудиторский след.
Дальше идёт подготовка документа. Обычно это валидация файла, антивирусная проверка, разделение на страницы, нормализация изображений, исправление ориентации и оптическое распознавание символов. В нативных PDF текст часто уже пригоден для работы, а для сканов нужен OCR. Качество изображения напрямую влияет на точность классификации, поэтому предобработка относится к инженерным задачам, а не к второстепенным мелочам.
Затем классификатор определяет, что это за документ. В зависимости от сценария он может опираться на текст, визуальную вёрстку, метаданные или на всё сразу. В банковской выписке и счёте могут встречаться похожие слова и цифры, но их вёрстка, заголовки, структура таблиц и повторяющиеся паттерны различаются. Мультимодальные подходы улучшают результат, когда визуальная структура несёт смысл. Текстовых моделей может хватить, если шаблоны документов относительно стабильны, а результат OCR надёжен.
Результат классификации должен поступать в оркестрационный слой, который применяет бизнес-правила. Счёт с высокой уверенностью уходит на извлечение и сверку. Документ с низкой уверенностью попадает в очередь на проверку. Файл с несколькими типами документов можно разделить на отдельные записи. Документ, похожий на содержащий чувствительную информацию, может требовать ограниченной маршрутизации или проверки по политике перед дальнейшей обработкой.
Наконец, процесс записывает результаты обратно в системы, где идёт работа. Это может быть ERP, CRM, платформа урегулирования убытков, система управления документами, платформа поддержки, хранилище данных или внутреннее приложение для ведения кейсов. Без такой интеграции сотрудники по-прежнему копируют результаты вручную, и автоматизация не дотягивает до своего бизнес-обоснования.
Классификация и извлечение решают разные задачи
Команды часто смешивают эти понятия, но задачи у них разные. Классификация отвечает на вопрос «Что это за документ?». Извлечение отвечает на вопрос «Какие данные в нём есть?». Процессу маршрутизации может хватить классификации. Процессу обработки счетов обычно нужны и классификация, и извлечение, а затем сверка с заказом на закупку или справочником поставщиков.
Разделение этих функций упрощает тестирование и доработку системы. Классификатор может быть точным, а модель извлечения при этом не справляется с новым шаблоном. И наоборот, извлечённые поля могут показать, что документу присвоен неверный класс. Продакшен-системы должны позволять отслеживать эти компоненты по отдельности.
Постройте таксономию, которую смогут поддерживать операционные команды
Метки документов должны говорить на языке бизнеса. Если операционная команда называет файл «подтверждением доставки», это должно быть категорией или понятной сопоставленной меткой, а не абстрактной меткой модели, которую может расшифровать только специалист по данным.
Первую таксономию держите достаточно узкой, чтобы она поддерживала чёткие решения. Разумно начать с типов документов, на которые приходится основной входящий объём, больше всего ручных операций или задержек обработки. Редкие классы можно отправлять в категорию «прочее» или на проверку человеком, пока не накопится достаточно данных для их автоматизации.
Качество разметки ценнее большого, но непоследовательного обучающего набора. Опишите правила разметки для пограничных случаев. Например, решите, считать ли объединённые счёт и упаковочный лист одним классом, двумя классами или пакетом из нескольких документов. Решите, как размечать изменённые договоры, неполные заявки, дубликаты и нечитаемые сканы. Эти решения становятся частью операционной модели.
Там, где это разрешено, используйте реальные исторические документы с необходимым обезличиванием, контролем доступа и правилами хранения. Образцы данных редко отражают тот беспорядок, который приходит в продакшене. Обучающий и оценочный наборы должны включать документы от разных поставщиков, клиентов, из разных регионов, разного качества сканирования и за разные периоды.
Проектируйте с учётом уверенности, исключений и проверки человеком
Ни один серьёзный документооборот не должен исходить из того, что каждый прогноз верен. Пороги уверенности служат практической точкой контроля между автоматизацией и проверкой. Порог должен зависеть от типа документа и последствий дальше по процессу.
Для задачи маршрутизации с низким риском классификатор может автоматически обрабатывать прогнозы выше согласованного порога, а остальное отправлять в очередь на проверку. Для записей, чувствительных с точки зрения комплаенса, или документов, запускающих финансовые операции, порог должен быть строже, и могут понадобиться дополнительные проверки. Оценка уверенности модели сама по себе ещё не бизнес-политика. Её нужно сочетать с типом документа, источником, проверками полноты и риском процесса.
Интерфейс проверки важен не меньше модели. Проверяющий должен видеть исходный файл, предсказанную категорию, уровень уверенности, значимые извлечённые признаки и простой способ исправить результат. Исправления нужно сохранять как структурированную обратную связь, а не прятать в заметках. Так появляется надёжный набор данных для дообучения, и становится понятно, откуда берутся сбои: из OCR, неоднозначной таксономии, изменения шаблонов поставщиков или дрейфа модели.
Хорошо продуманная обработка исключений также не допускает тихих сбоев. Если OCR почти не вернул читаемого текста, файл защищён паролем, PDF повреждён или классификатор выдал неподдерживаемую категорию, система должна создать видимую задачу, а не оставлять документ в неопределённом состоянии.
Безопасность и комплаенс должны определять разработку
Классификация документов часто затрагивает персональные данные, финансовую и медицинскую информацию, договоры и конфиденциальные деловые записи. Безопасность нельзя добавить после того, как пилот оказался успешным.
Продакшен-архитектура должна обеспечивать минимально необходимые права доступа, шифрование при передаче и хранении, разделение сред, безопасное управление секретами и подробное логирование доступа к файлам и результатов классификации. Политики хранения и удаления данных должны соответствовать юридическим и операционным требованиям организации. Там, где действуют регуляторные обязательства, процесс должен сохранять прослеживаемость: что поступило, как это обработано, какая классификация получена, кто её переопределил и какая система получила результат.
Выбор модели и поставщика тоже зависит от этих требований. Одни организации могут использовать управляемые ИИ-сервисы в одобренных облачных средах. Другим нужны частные схемы развёртывания, ограниченная работа с данными или особые региональные механизмы контроля. Универсального ответа нет. Архитектура должна соответствовать классификации данных и подходу компании к комплаенсу.
Измеряйте результат, а не только точность модели
Точность необходима, но операционной ценности она не доказывает. Модель может показывать хорошие цифры на тестах и при этом давать мало эффекта, если результаты не встроены в процесс или проверяющие слишком долго разбирают исключения.
Отслеживайте точность классификации по каждому классу, но также следите за долей автоматизации, долей исключений, средним временем обработки, переделками, возрастом очередей и процентом документов, которые доходят до нужной системы без ручного вмешательства. Для финансовых процессов измеряйте время цикла и стоимость обработки одного документа. Для андеррайтинга и урегулирования убытков измеряйте сроки обработки и сокращение бэклога. Эти метрики показывают, даёт ли решение конкретную автоматизацию, а не общий шум вокруг ИИ.
Запускайте внедрение поэтапно. Начните с ограниченного набора документов и контролируемой группы пользователей. Работайте в теневом режиме, если риск высок: пусть система классифицирует документы, пока сотрудники продолжают работать по прежним процессам, а затем сравните результаты. Когда точность и обработка исключений подтверждены, включите автоматическую маршрутизацию сначала для классов с самым низким риском. Расширяйте охват только тогда, когда процесс, интеграции и механизмы управления выдерживают реальную нагрузку.
Превратите классификацию в рабочий процесс
Сильные программы документного ИИ не рассматривают классификацию как отдельную функцию. Они используют её как первый уровень принятия решений в более крупной системе: приём, валидация, извлечение, маршрутизация, согласования и отчётность. Именно там операционный эффект накапливается.
Invatechs подходит к таким проектам как к внедрению ПО и рабочих процессов: связывает результаты ИИ с системами, которыми команды уже пользуются, и выстраивает механизмы контроля, необходимые для продакшена. Задача не в том, чтобы показать, что модель умеет распознавать документ. Задача в том, чтобы сократить ручной труд, не внося новой неопределённости в критически важный процесс.
Начните с одного решения по документам, которое принимается часто, стоит дорого и поддаётся измерению. Когда это решение встроено в правильный процесс, классификатор становится не просто ИИ-функцией. Он становится надёжной частью того, как бизнес продвигает работу вперёд.