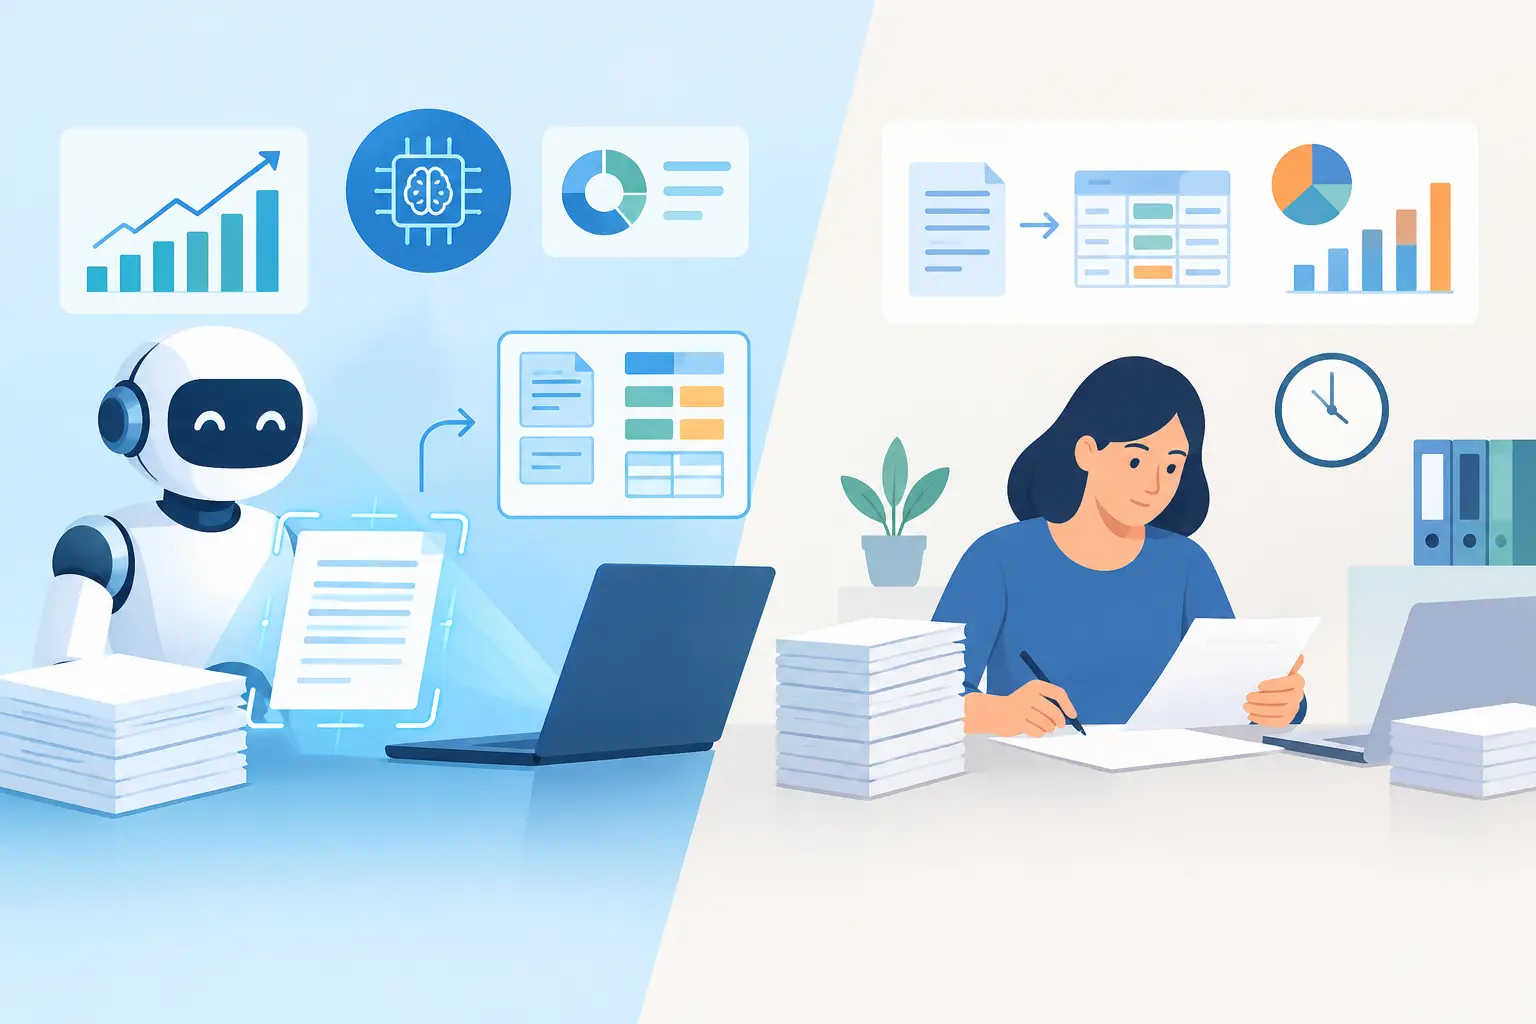
Команда по обработке страховых случаев получает 8000 документов в неделю. Часть из них это аккуратные PDF, сформированные порталом. Остальное это сфотографированные формы, многостраничные счета, рукописные заметки и вложения в письмах с произвольными именами. Выбирая между ИИ-распознаванием (AI OCR) и ручной обработкой, вы решаете вовсе не вопрос, умеет ли программа читать текст. Вопрос в том, сможет ли ваша операционная команда превращать входящие документы в надёжные, пригодные к использованию данные, не создавая ещё большую очередь исключений или проблему с комплаенсом.
Ручная обработка кажется надёжной, потому что люди понимают контекст, устраняют неоднозначности и применяют собственное суждение. Но с ростом объёма она становится дорогой и плохо управляемой. AI OCR может резко сократить повторяющуюся работу, но только если он спроектирован как часть процесса с проверкой, маршрутизацией, интеграцией с системами и участием человека там, где это необходимо.
Для большинства компаний со сложными операционными процессами правильный ответ не сводится к простой замене одного другим. Нужен рабочий процесс в продакшене, который поручает рутинное извлечение данных ИИ, а неоднозначные или рискованные случаи направляет квалифицированным сотрудникам.
AI OCR и ручная обработка: операционная разница
Ручная обработка обычно идёт по знакомой схеме: сотрудник открывает файл, определяет тип документа, читает нужные поля, вводит данные в CRM, ERP, систему обработки страховых случаев или таблицу и сверяет результат с регламентом или бизнес-правилами. Такой процесс гибок, но зависит от доступности сотрудников, качества обучения и стабильности исполнения.
AI OCR меняет эту схему. Документ поступает по электронной почте, через клиентский портал, файловое хранилище или API. Система классифицирует его, извлекает нужный текст и поля, проверяет значения и отправляет структурированные данные в последующие системы. Записи, которые проходят пороги уверенности и бизнес-правила, могут двигаться дальше автоматически. Записи, которые их не проходят, попадают в очередь проверки, где проверяющий видит исходный документ и отмеченные поля.
Это различие важно. Сам по себе OCR не решает операционную задачу. Если система прочитала «Invoice Total» в PDF, это ещё не подтверждает, что сумма совпадает с заказом на закупку, относится к утверждённому поставщику, указана в правильной валюте и должна быть отнесена на конкретный центр затрат. Работающее решение сочетает интеллектуальную обработку документов с логикой процесса.
В чём ручная обработка всё ещё выигрывает
Проверка человеком остаётся лучшим вариантом при небольших объёмах, сильно различающихся документах и решениях, которые требуют интерпретации, а не извлечения. Юридический договор с необычными условиями, медицинское заключение или заявка на андеррайтинг с неполными доказательствами могут потребовать опытного суждения, которое не стоит автоматизировать.
Ручная обработка также оправдана, когда сам процесс меняется каждую неделю. Если автоматизировать нестабильный процесс слишком рано, путаница окажется закреплена в ПО. В таком случае описание текущего процесса, определение нужных данных и стандартизация приёма документов могут дать больше пользы до начала разработки ИИ.
Обратная сторона в том, что у ручной работы есть скрытые операционные затраты. Руководители часто считают рабочие часы, но упускают из виду переделки, задержки согласований, выборочный контроль качества, текучесть кадров, обучение, управление очередью и цену данных, по-разному внесённых в разные системы. Процесс, который работает при 200 документах в месяц, может быстро сломаться при 20 000.
Что AI OCR делает хорошо и где даёт сбой
Современный AI OCR эффективно извлекает данные из полуструктурированных и неструктурированных документов, включая счета, заявки, коносаменты, налоговые формы, удостоверения личности и переписку. Он умеет классифицировать документы, находить пары «ключ - значение», определять таблицы и по окружающему контексту отличать адрес плательщика от адреса доставки.
Особенно это ценно, когда команды постоянно работают с одними и теми же категориями документов, но получают их из множества источников и в разных форматах. Вместо жёсткого шаблона для счёта каждого поставщика уровень извлечения на основе ИИ может обобщать типичные варианты. Это сокращает усилия на настройку и расширяет охват по мере появления новых форматов.
При этом AI OCR не отменяет необходимости контроля. Точность могут снижать некачественные сканы, рукописный текст, необычная вёрстка, отсутствующие страницы, противоречивые значения и незнакомые типы документов. К тому же приводят и метки, которые встречаются в нескольких местах, например несколько дат или итоговых сумм в одном документе.
Система продакшен-уровня считает неуверенность событием процесса, а не чем-то постыдным. Она фиксирует уверенность извлечения, применяет детерминированные правила проверки и сохраняет аудиторский след от структурированного поля до исходной страницы. Проверяющий должен видеть, почему запись отмечена, и исправлять её, не вводя весь документ заново.
Сравнивайте затраты по пропускной способности, исключениям и риску
Сравнение затрат редко сводится к формуле «подписка на ПО против зарплаты сотрудника». Затраты на ручную обработку в основном переменные: больше документов обычно требует больше часов. У AI OCR есть затраты на внедрение, интеграцию, мониторинг и использование, но после выхода на стабильную работу он может обрабатывать рутинный объём с гораздо меньшими предельными затратами.
Экономическое обоснование становится сильнее, когда команда тратит много времени на повторяющееся извлечение данных, объёмы документов предсказуемы или растут, а данные нужно вводить более чем в одну систему. Оно усиливается и тогда, когда медленная обработка создаёт дополнительные расходы дальше по цепочке: задержки при подключении клиентов, просроченные сроки оплаты, более медленное урегулирование страховых случаев или плохое время ответа клиентам.
Ключевой показатель здесь доля исключений. Если 90% рутинных документов можно автоматически извлечь, проверить и провести, оставшиеся 10% получат целенаправленное внимание людей. Если половине всех документов нужна обстоятельная проверка, проблема может быть в плохом качестве входных данных, нечётких требованиях к данным, недостаточной логике проверки или в категории документов, которая пока не подходит для автоматизации.
Риск тоже меняет расчёт. В финансах, страховании, здравоохранении и регулируемых процессах неверное поле может обойтись дороже задержанного. Это не означает автоматически, что ручная работа лучше. При ручном вводе тоже бывают ошибки. Это значит, что автоматизации нужны правильные пороги одобрения, разделение обязанностей, логирование, правила хранения и обработка исключений, соответствующие процессу.
Архитектура надёжной автоматизации документов
Самые сильные программы AI OCR начинаются с узкого измеримого процесса, а не с широкого обещания автоматизировать все документы. Компания может начать со счетов поставщиков для одного подразделения, с приёма заявок на кредит или с извлечения заявок на обслуживание из PDF, присланных по почте.
Сначала определите документы, целевые поля, допустимую долю ошибок, ожидаемые сроки обработки и владельцев исключений. Затем определите системы учёта. Если извлечённые данные попадают в таблицу, прежде чем кто-то заново внесёт их в ERP, процесс не решил основную проблему.
Типичная архитектура включает уровень приёма, хранилище документов, сервисы классификации и извлечения, проверку по бизнес-правилам, интерфейс для проверки человеком и коннекторы к операционным системам. Конкретный стек зависит от требований безопасности и имеющихся платформ, но у каждого компонента своя чёткая задача.
Проверка заслуживает особого внимания. Она должна включать контроль обязательных полей, форматов дат, поиск дублей счетов, налоговые расчёты, сопоставление поставщиков, лимиты по регламенту и перекрёстную сверку с мастер-данными. ИИ может интерпретировать документ, а правила и подключённые системы определяют, можно ли передать извлечённый результат на следующий шаг.
Проверку с участием человека нужно проектировать с расчётом на скорость. Проверяющим нужно видеть рядом исходный файл, извлечённые значения, сигналы уверенности и контекст соответствующего аккаунта или обращения. Их исправления должны идти в мониторинг и работу над улучшениями, а не исчезать в неизмеряемой очереди.
Безопасность и комплаенс: требования к внедрению
В документообороте часто встречаются персональные данные, финансовые сведения, медицинская информация, договоры и внутренние рабочие записи. Отправка файлов в OCR-сервис без проверки того, как он обращается с данными, контролирует доступ, хранит информацию и выполняет договорные требования, создаёт ненужные риски.
При внедрении нужно определить, кто может отправлять документы, кто может просматривать исходные файлы, кто может одобрять исправления и какие системы получают итоговые данные. Шифрование, ролевой доступ, журналы аудита, разделение сред и контроль хранения нужно планировать до развёртывания, а не добавлять после выхода пилота в продакшен.
Для процессов с повышенными требованиями к комплаенсу организациям также нужна обоснованная запись о том, что было извлечено, какая проверка выполнена, вмешивался ли человек и какая версия процесса приняла решение. Именно здесь типовые ИИ-демо часто останавливаются. Операционное требование здесь - прослеживаемость.
Как решить, с чего начать
Выберите процесс с достаточно большим объёмом, понятными входами и выходами и заметной операционной проблемой. Лучшие первые сценарии обычно повторяющиеся, но не тривиальные: у них измеримое время обработки, общие поля данных и определённое следующее действие.
Прежде чем начинать разработку, измерьте исходный уровень. Зафиксируйте текущий объём документов, среднее время обработки, долю ошибок и переделок, срок выполнения, возраст очереди и число задействованных сотрудников. Затем определите успех в бизнес-терминах: например, сокращение ручных действий на 60%, уменьшение времени приёма с двух дней до двух часов или повышение полноты данных до того, как записи попадут к операционной команде.
Пилот должен проверять репрезентативные документы, включая плохие сканы и пограничные случаи, а не только самые чистые примеры. Он также должен подтвердить путь интеграции, удобство проверки и процесс мониторинга. Invatechs подходит к этой работе как к задаче связанной разработки ПО: качество извлечения важно, но не менее важны API, QA, контроль и результаты процесса вокруг него.
Практичный следующий шаг: взять один процесс с большим объёмом документов и составить карту его исключений. Эти исключения покажут, что должно остаться за людьми, что можно проверять правилами и где AI OCR снимет повторяющуюся работу, которая мешает опытным командам двигать бизнес вперёд.