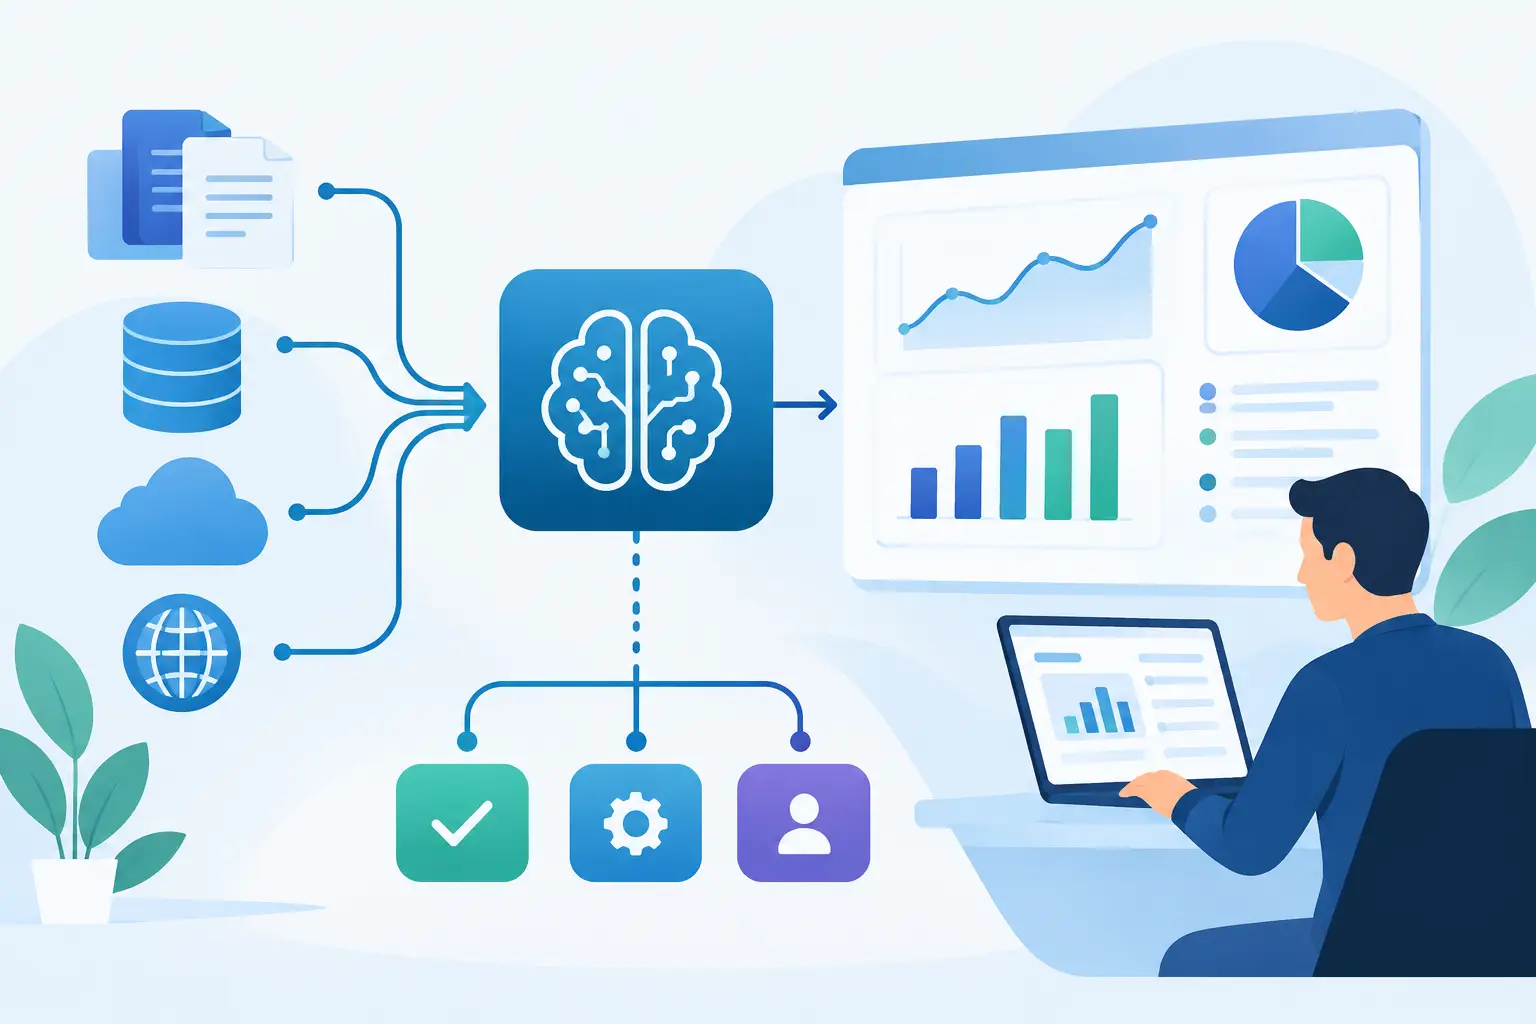
Агент поддержки называет клиенту устаревшие условия возврата. Ассистент андеррайтера упускает обновлённое правило оценки риска. Копилот отдела продаж приводит цены прошлого квартала. Проблема здесь обычно не в модели. Проблема в доступе к знаниям. Вопрос о том, когда компаниям стоит использовать RAG, важен потому, что польза ИИ в продакшене зависит от актуальной и разрешённой к использованию информации, которую он может найти и применить.
Retrieval-augmented generation, или RAG, позволяет ИИ-приложению искать по утверждённому бизнес-контенту, прежде чем сформировать ответ. Языковой модели не приходится полагаться только на данные, на которых она обучалась: приложение находит нужные документы, записи или фрагменты политик и передаёт этот контекст во время выполнения.
В компаниях со сложными операциями RAG может превратить ИИ в рабочее ПО, подключённое к системам, где принимаются решения. Однако он подходит не для каждой задачи с ИИ. Его ценность зависит от типа знаний, цены неверного ответа, качества исходных данных и процесса, в который встроена модель.
Когда компаниям стоит использовать RAG?
RAG стоит использовать, когда ИИ-системе нужно работать с информацией, которая принадлежит компании, часто меняется, распределена по бизнес-системам или защищена правилами доступа. Особенно хорошо он работает там, где пользователям нужны ответы, опирающиеся на первоисточники, а не правдоподобные общие формулировки.
Возьмём сервисную организацию, где агенты работают с CRM, документацией по продукту, договорами, внутренними политиками и историей тикетов. Универсальная модель может хорошо писать, но она не знает, какая версия договора действует для конкретного клиента и не изменилась ли политика вчера. Слой RAG может найти нужную запись о клиенте, утверждённую политику и инструкции по продукту ещё до того, как модель подготовит черновик ответа.
Та же схема подходит операционным командам, которые обрабатывают счета, страховые случаи, заявки, запросы поставщиков, проверки на соответствие требованиям и обращения в техподдержку. В каждой из этих ситуаций модели нужен актуальный контекст из учётных систем. RAG даёт этот контекст, и вам не приходится переобучать модель при каждом изменении бизнес-знаний.
Четыре условия ясно показывают, что RAG стоит рассмотреть:
- Для повторяющейся работы вашей команде нужны большие объёмы документов, контента из базы знаний или системных записей.
- Информация меняется так часто, что статичные промпты и обучение модели быстро устаревают.
- Пользователям нужны проверяемые ответы с цитатами, выдержками из источников или ссылками на первичную запись.
- Доступ к информации должен зависеть от ролей, клиентских аккаунтов, регионов, отделов или требований комплаенса.
Эти признаки касаются не только техники. Они указывают на операционную возможность: сократить время, которое сотрудники тратят на поиск информации, сверку противоречивых документов и ручной перенос контекста между системами.
Какие бизнес-задачи RAG решает хорошо
Наибольшую ценность RAG приносит, когда поиск напрямую связан с действием или решением. Отдельный чат-бот, который ищет по библиотеке документов, может быть полезен, но его эффект ограничен, если сотрудникам всё равно нужно копировать ответы в другие системы и завершать работу вручную.
Более сильная реализация находит знания, готовит рекомендацию или черновик в заданных рамках и передаёт результат в управляемый рабочий процесс. Например, ассистент отдела урегулирования убытков может найти формулировки полиса, заметки по прошлым случаям и нужные формы, а затем собрать пакет документов для специалиста. За решение по-прежнему отвечает специалист, а система сокращает поиск и работу с документами.
Ещё одно практичное применение: клиентская поддержка. Пока агент работает с тикетом, RAG может показать подходящую статью по устранению неполадок, настройки конкретного аккаунта и свежие инструкции по инцидентам. В типовых обращениях с низким риском он может подготовить ответ или обеспечить самообслуживание. В более чувствительных случаях он может дать агенту источники и рекомендуемый следующий шаг.
Команды продаж и управления аккаунтами могут с помощью RAG готовить сводки по аккаунтам на основе записей CRM, условий продления, данных об использовании продукта и утверждённых материалов. Юристы, финансисты и закупщики могут находить нужные пункты договоров, сравнивать требования к поставщикам или направлять документы на проверку. Общее требование здесь не сводится к фразе «у нас есть документы». Людям регулярно нужна правильная информация, чтобы продвинуть бизнес-процесс дальше.
RAG не заменяет порядок в системах
RAG не исправит противоречивые политики, дубли записей о клиентах, документы без ответственного или слабую настройку прав. Он может быстро вскрыть эти проблемы, потому что при поиске качество исходных материалов становится заметно в ответах ИИ.
Если три версии ценовой политики проиндексированы без чётких дат вступления в силу, система может найти все три. Если у слоя поиска нет метаданных о продуктовой линейке, сегменте клиентов или юрисдикции, модель может получить контекст, в целом близкий к теме, но неверный для конкретной операции. Модель работает только с тем, что ей даёт архитектура.
Поэтому RAG в продакшене требует большего, чем загрузка файлов в векторную базу данных. Документы нужно правильно разобрать, разбить на фрагменты с сохранением смысла, снабдить полезными метаданными и синхронизировать при изменении исходного контента. Структурированные данные часто лучше получать напрямую через API или из базы данных, а не только поиском по документам. Текущий баланс клиента, статус открытого тикета или объём его прав должны поступать из учётной системы, а не из скопированного PDF.
На архитектуру должны влиять и требования безопасности. Поиск должен проверять права до того, как контент попадёт в модель. Пользователь, которому недоступен договор в исходной системе, не должен получить его через промпт к ИИ. Журналы аудита, правила хранения, шифрование, контроль поставщиков и точки согласования человеком нужно закладывать в реализацию сразу, особенно в регулируемых процессах или процессах с высокими требованиями к комплаенсу.
Когда RAG не подходит
RAG не нужен, если задача не зависит от внутренних или актуальных знаний. Общая помощь с текстами, брейншторм, форматирование кода, перевод и резюме документа, уже переданного в промпте, могут обойтись без системы поиска.
Это также неудачная первая инвестиция, если сам бизнес-процесс не определён. Если команда не может договориться о текущей политике согласования, порядке эскалации или источнике истины, ИИ лишь усилит путаницу. Сначала проясните процесс и назначьте ответственных за исходные знания.
Некоторым задачам нужен другой технический подход. Дообучение (fine-tuning) может помочь, когда цель заключается в едином стиле, стабильной классификации или шаблонах структурированного вывода, которые меняются нечасто. Для детерминированной логики проверки прав и расчётов лучше по-прежнему подходят классические движки правил. Автоматизация рабочих процессов может устранить ручную передачу задачи вообще без LLM.
Во многих продакшен-системах правильный ответ состоит в сочетании подходов: правила для решений без права на отклонение, API для актуальных транзакционных данных, RAG для поиска по политикам и знаниям и LLM для интерпретации, подготовки текста и общения с пользователем. Архитектура должна следовать за риском решения, а не за модой.
Стройте RAG вокруг измеримого рабочего процесса
Надёжнее всего оценивать RAG на одном процессе с чёткими границами. Выберите рабочий процесс с объёмом, достаточным для подтверждения ценности, определённой группой пользователей, доступными исходными системами и измеримыми критериями качества. Для начала хорошо подходят решение обращений в поддержку, приём документов, помощь по внутренним политикам, подготовка коммерческих предложений и сбор свидетельств для комплаенса.
Ещё до разработки определите, как выглядит правильный результат. Это может быть точность ответов, релевантность источников, время решения, доля случаев, закрытых без эскалации, сокращение времени обработки или меньшее число исключений из политик. Составьте тестовый набор из реальных прошлых случаев, включая неоднозначные запросы и известные пограничные ситуации. Проверка только на отполированных демо-вопросах создаёт ложную уверенность.
Слой поиска нужно тестировать отдельно от ответа модели. Если нужный источник не найден, улучшение промптов проблему не решит. Команды должны измерять, находит ли система правильный документ, версию, запись и фрагмент. Затем следует оценить, точно ли сгенерированный ответ использует этот материал, соблюдает ли нужный формат и обходится ли без неподтверждённых утверждений.
Для результатов с высокой ценой ошибки проверка человеком остаётся уместной. Хорошо спроектированная система умеет отличать задачи с низким риском, которые можно автоматизировать, от случаев, требующих эскалации. Пороги уверенности, проверки на отсутствующие данные и маршрутизация по политикам переводят это различие из теории в практику.
В Invatechs это значит, что мы относимся к RAG как к встроенной возможности ПО, а не функции чат-бота. Защищённые коннекторы, поиск с учётом ролей, действия в рабочих процессах, QA, мониторинг и постоянное управление контентом превращают ИИ-прототип в надёжную бизнес-систему.
Начните там, где нехватка знаний задерживает работу
Лучшая возможность для RAG часто прячется в очереди: тикеты ждут исследования, документы ждут проверки, запросы ждут того, кто знает, где искать ответ. Прежде чем выбирать модель, сопоставьте эту задержку с её источниками, правилами принятия решений и передачами между людьми.
Если рабочему процессу нужны актуальные внутренние знания, а ответ должен опираться на источники, учитывать права доступа и вести к действию, RAG, скорее всего, хорошо подойдёт. Постройте первую реализацию вокруг узкого решения, подтвердите качество на реальной работе и расширяйте её только после того, как поиск и средства контроля заслужат доверие.